智慧对话 · 深度求索未至之境
DeepSeek - 探索未至之境。深度求索(Deep Seek)坚持以底层纯强化学习技术攻坚人工智能前沿。依托自研 Multi-head Latent Attention (MLA) 显存架构与极低训练成本,全面开放 DeepSeek-R1 满血版思考模型,重构通用推理智能边界。
数学奥赛卓越表现
在 AIME 2024 与 MATH-500 测试集中,DeepSeek-R1 纯强化学习模型准确率超越国际同级闭源模型。
纯强化学习长程反思
无需海量人工标注微调,模型在数学与代码的大规模规则博弈中自发涌现深层思维链与错误纠偏能力。
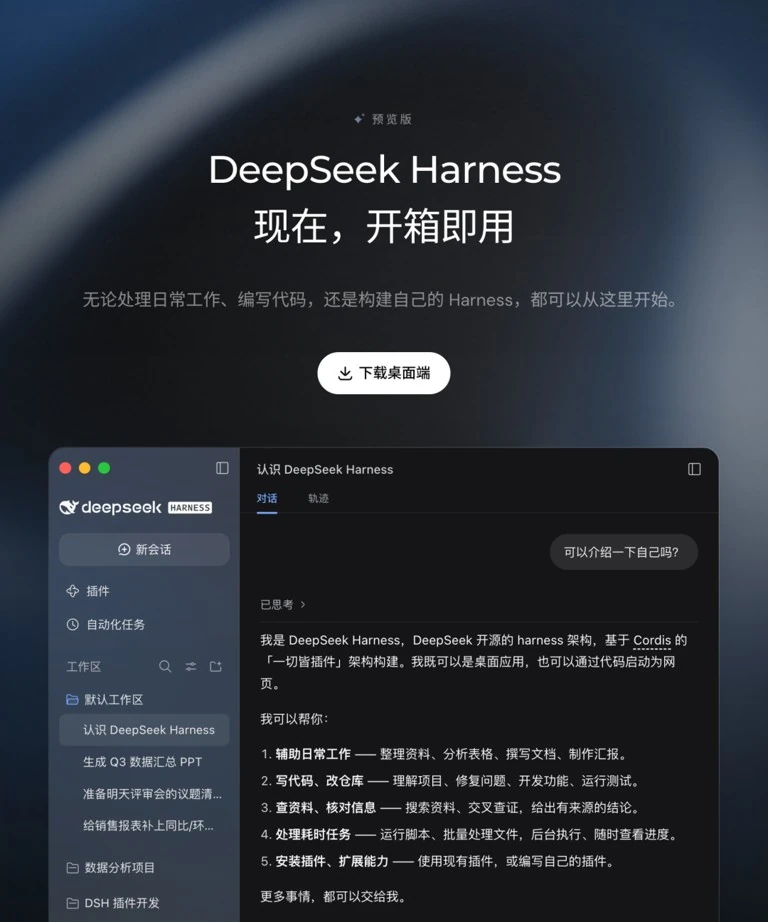
全量开源权重与 DeepSeek Harness 标准套件
全网开源满血权重与蒸馏模型,配套发布 DeepSeek Harness 容器化自动化打分套件,赋能全球开发者自由复现学术论文成果。
冷静克制 · 聚焦底层逻辑与工程能效
DeepSeek AI 从未停止对前沿通用智能的本质追问。通过稀疏 Mixture-of-Experts (MoE) 架构与多步推演采样算法,我们在单卡吞吐量与长文档生成速度上实现了工业级提升。
无论在 DeepSeek官网 进行科研公式推导,还是调用 DeepSeek api开放平台 赋能生产级软件系统,我们均提供极其稳健的低延迟支持与最高规格的数据私密性保障。
客观严谨 · 全球前沿大模型基准实测
基于业界通用且可确定性复现的官方 Harness 评测集统计
| 测试数据集 (Benchmark) | DeepSeek-R1 (官方实测) | OpenAI o1-mini | Claude 3.5 Sonnet | GPT-4o (通用版) |
|---|---|---|---|---|
| AIME 2024 (数学竞赛) | 79.8% | 63.6% | 16.0% | 9.3% |
| MATH-500 (高阶数学推理) | 97.3% | 90.0% | 78.3% | 74.6% |
| Codeforces (算法竞赛排位) | 96.3% | 93.4% | 77.2% | 62.8% |
| MMLU (多学科综合知识) | 90.8% | 85.2% | 88.3% | 87.2% |